الوحدة الثالثة: أدوات الذكاء الاصطناعي وتقنيات تصميم المُنطلق

مقرر الذكاء الاصطناعي وتطبيقاته (1117) — جامعة القدس المفتوحة — تأليف: المهندس رائد زحالقة

مقدمة الوحدة

تهدف هذه الوحدة إلى تمكينك من الاستخدام الواعي والعملي لأدوات الذكاء الاصطناعي التوليدية عبر النص/الصورة/الصوت مثل ChatGPT وDeepSeek وQwen وManus وGoogle NotebookLM وSora، من خلال أنشطة معملية تربط التعلم بمهام دراسية ومهنية واقعية.

كما تتناول الوحدة هندسة المُنطلق (Prompt Engineering) وصياغة المُنطلقات الفعالة عبر بناء واضح يشمل: السياق، الدور/الشخصية، المهمة، القيود، الجمهور، الأسلوب، وتنسيق المخرجات. وتتعرف من خلالها على أنماط المُنطلقات المتقدمة مثل Zero-shot وFew-shot وChain-of-Thought، مع تبني دورة التحسين التكراري: «صياغة → تشغيل → نقد → تحسين».

يتوقع منك بعد دراسة هذه الوحدة أن تتقن بناء واستخدام المُنطلقات (Prompts)، والاستخدام الواعي والأخلاقي لأدوات الذكاء الاصطناعي التوليدية في مهام دراسية ومهنية، ضمن إطار منظم وأخلاقي.

أدوات الذكاء الاصطناعي التوليدية

تقدم هذه الوحدة مدخلاً عملياً ومكثّفاً إلى أدوات الذكاء الاصطناعي التوليدية (Generative AI)، وهي نماذج تتعلّم الأنماط والبنى من بيانات التدريب لتُنشئ نصوصاً وصوراً ووسائط جديدة تحمل خصائص مماثلة. تهدف الوحدة إلى تمكينك من تمييز قدرات المنصّات وحدودها، واختيار الأداة المناسبة للمهمة، وصياغة مُنطلقات فعالة، وتقييم المخرجات بصورة مسؤولة وأخلاقية.

نموذج لغة كبير (LLM) طوّرته شركة OpenAI، أُطلق في 30 نوفمبر 2022 وأصبح التطبيق الأسرع نمواً في التاريخ (100 مليون مستخدم نشط شهرياً خلال شهرين فقط). يعتمد على هندسة المحولات (Transformers) وتقنيات التعلم المعزز من ردود الفعل البشرية (RLHF)، ويتميز بقدرته على تذكر سياق المحادثة. قدراته: كتابة وتحرير المحتوى، التلخيص، البرمجة، التحليل الإحصائي، العصف الذهني، دعم البحث العلمي والتعليم. من أبرز قيوده: الهلوسة (معلومات خاطئة أحياناً)، التحيز المحتمل من بيانات التدريب، مخاوف الخصوصية، ومعرفة محدودة بالأحداث بعد تاريخ تدريبه. يتوفر بإصدار مجاني وإصدار مدفوع (ChatGPT Plus) بسعر يبدأ من 20$ شهرياً.
منصة ذكاء اصطناعي توليدي صينية (نموذج DeepSeek-V3)، بحجم 671 مليار معامل ومدرّبة على 14.8 تريليون رمز نصي، ما يضعها ضمن فئة النماذج اللغوية الكبيرة (LLMs). تتميز بأداء حاسوبي مرتفع ودعم تعدد الأنماط (وإن كانت لا تدعم الصور حالياً)، وتُصنَّف كبديل قوي منافس لـ ChatGPT وClaude وQwen. مناسبة بشكل خاص لتحليل النصوص والبيانات الضخمة وإعداد الملخصات والتقارير كثيفة المعلومات، لكنها تستهلك موارد حاسوبية عالية.
منصة طوّرتها شركة Alibaba، من أبرز منصات الذكاء الاصطناعي التوليدي القائمة على النماذج اللغوية الكبيرة. خصائصها الأساسية: مفتوحة المصدر (Open-Source) تتيح للمطورين تعديلها واستخدامها، كفاءة عالية في الأداء، وقابلية تخصيص لمجالات متعددة (تعليم، خدمات، بحث علمي). يتصدر إصدارها المتقدم Qwen 2.5-Max مقارنات أقوى النماذج، لكنها تواجه تحدي محدودية الدعم المجتمعي مقارنة بمنصات مثل OpenAI.
منصة صينية طوّرتها شركة Butterfly Effect، تُوصف بأنها "وكيل ذكاء اصطناعي عام" (General AI Agent) في منزلة وسطى بين الذكاء الضيق والذكاء العام. تتجاوز كونها أداة تستجيب للأوامر لتصبح نظاماً قادراً على التخطيط واتخاذ القرار وتنفيذ مهام معقدة بشكل شبه مستقل، مثل إدارة جلسات عمل متعددة الخطوات، وتوليد محتوى مرئي ضمن مهمة أكبر، والتكامل مع متصفحات ومحررات وقواعد بيانات. من التحديات: مخاوف الخصوصية (بنيتها التحتية في الصين)، واعتمادها الجزئي على نماذج أخرى مثل Claude، وأثرها المحتمل على بعض الوظائف.
أداة تدوين ملاحظات وبحث مدعومة بالذكاء الاصطناعي من مختبرات جوجل (أُطلقت 2023 باسم Project Tailwind)، تعتمد على نماذج Gemini ومعالجة اللغة الطبيعية. أبرز ميزاتها: الملخصات الصوتية التفاعلية (Audio Overviews) الشبيهة بالبودكاست، حفظ الردود وتنظيمها (Pinboard)، تحميل وتلخيص أنواع متعددة من المحتوى (PDF، مواقع، فيديو يوتيوب)، والإجابة على أسئلة مدعمة باقتباسات من المصادر الأصلية. الفرق عن ChatGPT: تعتمد فقط على مستندات المستخدم (أكثر دقة لأبحاث محددة)، بينما ChatGPT يعتمد على بيانات إنترنت ضخمة.
نموذج توليد فيديو متطور من OpenAI، يحوّل الوصف النصي إلى مقاطع فيديو واقعية عالية الدقة (480 إلى 1080 بكسل)، مع الحفاظ على اتساق الشخصيات والأسلوب البصري عبر لقطات متعددة. من ميزاته: القصص المصورة (Storyboarding)، مزج المشاهد بسلاسة (Blending)، ومرشحات فنية جاهزة. تدعم المنصة أيضاً توليد الصور الثابتة (Text-to-Image) وترميم/تحرير الصور الموجودة عبر وصف نصي. لمعالجة إساءة الاستخدام، تضع OpenAI علامات مائية وبيانات وصفية على كل فيديو، وتحظر المحتوى الإباحي والتزييف العميق الضار.

لا تنحصر منصّات الذكاء الاصطناعي التوليدي في نطاق ثابت، بل تتزايد وتتبدّل بوتيرة متسارعة. لذلك يُنصح بمتابعة المستجدات بصورة منهجية عبر مجتمعات متخصصة، مع توظيف التفكير النقدي لتقييم جودة الأدوات وملاءمتها للأهداف التعليمية.

تطبيق عملي: توليد وترميم الصور بواسطة Sora

بالإضافة إلى الفيديو، تدعم منصة Sora إنشاء صور ثابتة من وصف نصي (Text-to-Image)، وكذلك ترميم وتحرير الصور الموجودة بناءً على وصف. إليك مثالاً فعلياً على إنشاء صورة ثابتة باستخدام مُنطلق يحدد المشهد والإضاءة ونسبة الأبعاد والأسلوب:
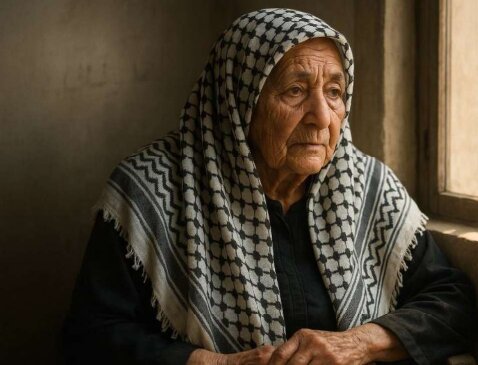
صورة ثابتة مولّدة بالذكاء الاصطناعي لامرأة مسنّة فلسطينية
مثال على صورة ثابتة (Still Image) وُلِّدت من مُنطلق نصي يحدد المشهد والإضاءة والأسلوب الفوتوغرافي الواقعي

أما ترميم/تحرير الصور القديمة، فيعتمد على رفع صورة موجودة ثم طلب تعديلات وصفية محددة (إزالة عنصر، استعادة التباين، تلوين، تحسين الإضاءة)، إما باستخدام أداة تحديد منطقة معينة (Mask/Selection) أو بوصف التعديل كتابياً. المثال التالي يوضح ترميم صورة تاريخية حقيقية مع الحفاظ الشديد على ملامح الوجه:
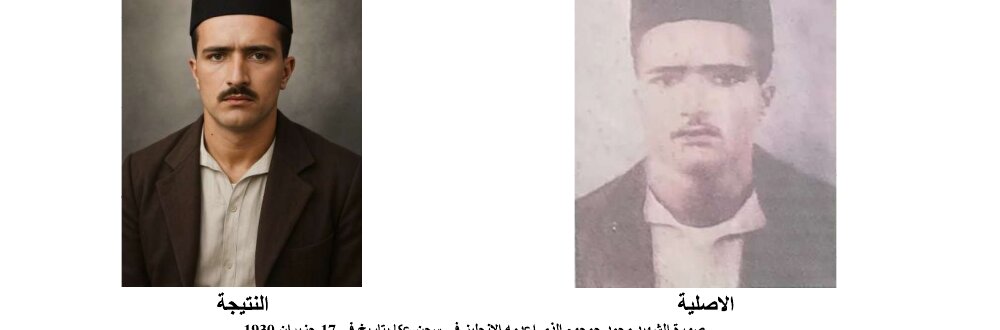
مقارنة بين الصورة الأصلية والنتيجة بعد الترميم بالذكاء الاصطناعي
صورة الشهيد محمد جمجوم الذي أعدمه الإنجليز في سجن عكا بتاريخ 17 حزيران 1930 — الأصلية (يمين) والنتيجة بعد الترميم التوليدي (يسار)

تنبيه مهم: نتائج ترميم الصور بالذكاء الاصطناعي هي "تحسينات توليدية تظهر كترميم"، وليست "استعادة مطابقة للأصل" بدقة أرشيفية. الأداة تعيد بناء الصورة بالكامل لتحقيق الوصف، لذلك قد تظهر اختلافات طفيفة عن الأصل، وهو سلوك متوقع في النماذج التوليدية. يُنصح بتوثيق ذلك بجملة مثل: "هذه النسخة مُحسّنة توليدياً لأغراض العرض، قد لا تعكس التفاصيل الأصلية بدقة أرشيفية."

من أفضل الممارسات عند التحرير: تقسيم التعديلات إلى خطوات صغيرة (إزالة الخدوش ← تلوين البشرة ← تلوين الخلفية)، تحديد منطقة التعديل بوضوح، استخدام مراجع لونية لتقليل التشتت الأسلوبي، ومراعاة سياسات الخصوصية وحقوق الأشخاص الحقيقيين.

أساسيات المُنطلق (Prompt)

المُنطلق (Prompt) هو رسالة تعليمات منظّمة — تجمع السياق والهدف والدور والجمهور والقيود ومعايير وشكل المخرج، وقد تتضمن أمثلة توضيحية — تُقدَّم للنظام الذكي لتوجيه توليده نحو مخرجات دقيقة وملائمة وقابلة للتقييم والتحسين التكراري.

تماماً كما تحتاج إلى أساس قوي لبناء منزل، يحتاج المُنطلق إلى إطار عمل واضح ومنطقي لضمان فهم نموذج الذكاء الاصطناعي لنيتك بدقة. إليك المكونات الستة الأساسية:

يوفر المعلومات الأساسية الضرورية حول الموقف أو الموضوع، ويحدد "الصورة الكبيرة" لما يجب على النموذج فعله. مثال: "أنت تعمل لمجلة سفر فاخرة، وتكتب محتوى عن المنتجعات".
يحدد الشخصية التي يجب أن يتبناها النموذج، ما يوجّه النبرة والأسلوب. مثال: "أنت مدرب سفر خبير يكتب بأسلوب إعلامي وجذاب ووصفي".
يحدد بوضوح الهدف المحدد أو المنتج النهائي المتوقع. كن محدداً قدر الإمكان. مثال: "صغ مقالاً من 500 كلمة يسلط الضوء على 5 منتجعات شاطئية فاخرة".
المحددات التي يجب الالتزام بها. تشير الأبحاث إلى أن التعليمات الإيجابية (ماذا يجب أن يفعل) أكثر فعالية من القيود السلبية (ماذا يجب ألا يفعل). مثال: "استخدم أمثلة عددية بسيطة وخطوات مرقمة لا تتجاوز 5 نقاط".
الفئة المستهدفة التي ستقرأ الناتج، وتؤثر على درجة التفصيل والأسلوب. مثال: "إذا كان الجمهور طلبة سنة أولى، يجب أن يكون الشرح مبسطاً وواضحاً".
الشكل المطلوب للإجابة: قائمة، جدول، أو تنسيق JSON منظم. استخدام تنسيقات منظمة يقلل من "الهلوسات" ويحسّن الدقة. مثال: "جدول يتضمن (المفهوم | الصيغة | مثال عددي قصير)".

مثال متكامل (شرح قانون أوم):

الدور: أنت مساعد مختص في الشرح الجامعي.
المهمة: لخص المفاهيم الأساسية في قانون أوم لطلبة سنة أولى.
القيود: استخدم أمثلة عددية بسيطة وخطوات مرقمة لا تتجاوز 5 نقاط.
المخرجات: جدول يتضمن (المفهوم | الصيغة | مثال عددي قصير).

هذا المُنطلق يدمج كل العناصر في طلب واحد واضح: السياق ضمني (شرح لطلاب هندسة)، الدور يوجّه النبرة التعليمية، المهمة محددة بدقة، القيود تضمن الإيجاز، والمخرجات منظمة في جدول ثلاثي الأعمدة.

القوالب والأنماط الشائعة (Prompt Patterns)

فهم كيفية التحدث مع نماذج الذكاء الاصطناعي الكبيرة (LLMs) مهارة أساسية اليوم، تماماً مثل تعلم لغة جديدة. لا تحتاج أن تكون خبيراً في علوم الحاسوب لتكتب مُنطلقاً جيداً؛ العملية تكرارية، وتتحسن بالممارسة.

يطلب من النموذج تبني شخصية أو هوية معينة، كأنك تطلب من ممثل أداء دور محدد. يساعد على إنتاج استجابات متناسقة مع النبرة والخبرة المطلوبة. مثال: "تصرّف كخبير في العلاقات العامة، واكتب مسودة بريد إلكتروني رسمي يدعو الجهات الإعلامية لتغطية حدث إطلاق منتج جديد".
تقديم مثال واحد (one-shot) أو عدة أمثلة (few-shot) لتوضيح ما تتوقعه، بعكس "صفر أمثلة" (Zero-shot) حيث لا تُقدَّم أي أمثلة. كلما زادت الأمثلة الجيدة، زادت فرصة النموذج في محاكاة النمط المطلوب بدقة، خصوصاً في المهام المعقدة أو ذات التنسيق المحدد.
التفاعل المستمر مع النموذج وتقديم ملاحظات لتحسين المخرجات الأولية، مثل محادثة ثنائية لضبط النتيجة. مثال: "حاول مرة أخرى، اجعل النص الإعلاني أكثر إبداعاً ومرحاً بنسبة 50%، واستخدم استعارات حيوية". قاعدة ذهبية: راجع دائماً المخرجات، ولا تثق بالذكاء الاصطناعي بشكل أعمى.
طلب إنتاج إجابات بتنسيق محدد يسهّل قراءتها برمجياً. فوائده: يضمن الاتساق، يحد من الهلوسات (إجبار النموذج على الالتزام ببنية محددة)، ويسهّل إعادة استخدام البيانات في تطبيقات أخرى. مثال: "أخرج النتائج بدقة كقائمة JSON من الكائنات، كل كائن يحتوي على حقلين: 'حالة_الاستخدام' و'مثال'".

نصائح إضافية: كونوا واضحين ومحددين في اللغة، اختبروا وكرروا صيغاً مختلفة دون خوف من التجربة، ووثّقوا كل محاولة ومخرجاتها لتتبع ما نجح وما لم ينجح.

التكرار والتنقيح والاختبار (Iterate-Refine-Test)

هذا المفهوم يشبه إلى حد كبير كيف تتعلم مهارة جديدة من خلال التجربة والخطأ. بعد دراسته ستتمكن من إجراء دورات تحسين سريعة على المُنطلق، وتشخيص أخطاء المخرجات واقتراح تعديلات موجهة.

1

الصياغة (Draft)

تبدأ بكتابة مُنطلق أولي بسيط. تذكّر: جودة المخرجات تعتمد بشكل كبير على جودة المُنطلق.

2

التجريب (Run)

تُشغّل المُنطلق على منصة الذكاء الاصطناعي (مثل ChatGPT) وتنتظر الرد.

3

التقييم (Evaluate)

تنظر إلى الإجابة وتقرر هل هي دقيقة، واضحة، تغطي كل ما طلبته، وبالتنسيق الصحيح؟

4

التنقيح (Refine)

إذا لم تكن الإجابة مثالية، تعدّل المُنطلق الأصلي بتعليمات موجّهة واضحة، مثل "اجعله أكثر إقناعاً" بدلاً من "فكّر بشكل أفضل".

معايير قياس الجودة الأربعة: الدقة (هل المعلومات صحيحة وخالية من الهلوسة؟)، التغطية (هل غطّى كل الجوانب المطلوبة؟)، القابلية للتنفيذ (هل المخرجات عملية ومفيدة؟)، والاتساق مع التنسيق (هل التزم بالشكل المطلوب؟).

مثال عملي على التحسين التكراري:

المُنطلق الأصلي: اشرح مفهوم التسويق الرقمي.

الملاحظة (Feedback): المخرجات طويلة وغير منظمة.
أعد التوليد مع: نقاط مرقمة، ومثال عددي واحد، وخاتمة من سطرين.

المُنطلق المكرر: حاول مجدداً. اشرح مفهوم التسويق الرقمي في نقاط
مرقمة لا تزيد عن 6 نقاط. اذكر مثالاً عددياً واحداً لتوضيح فعاليته.
اختتم بخلاصة من سطرين.

لاحظ كيف تحوّلت الملاحظة العامة ("طويل وغير منظم") إلى تعليمات محددة وقابلة للتنفيذ (عدد نقاط أقصى، مثال عددي، خاتمة قصيرة) — وهذا جوهر مهارة التنقيح الفعّال.

استراتيجية إضافية مفيدة: A/B Prompting — إنشاء نسختين مختلفتين من المُنطلق لنفس المهمة، تشغيل كليهما، ثم مقارنة النتائج باستخدام معايير الجودة واختيار الأفضل.

مسرد المصطلحات

اضغط على كل بطاقة لعرض تعريف المصطلح.

الذكاء الاصطناعي التوليدي (Generative AI)
نماذج تتعلّم الأنماط من بيانات التدريب لتولّد نصوصاً/صوراً/صوتاً جديدة بخصائص مماثلة.
المُنطلق (Prompt)
رسالة تعليمات منظّمة (سياق، دور، مهمة، قيود، جمهور، أسلوب، تنسيق مخرجات) تُقدَّم للنظام لتوجيه التوليد نحو مخرجات دقيقة.
هندسة المُنطلق (Prompt Engineering)
مهارة صياغة المُنطلقات الفعالة للحصول على أفضل استجابة ممكنة من نماذج الذكاء الاصطناعي.
Zero-shot / Few-shot
أنماط مُنطلق: بدون أمثلة توضيحية (Zero-shot) أو مع مثال أو أكثر (Few-shot) لتوجيه النموذج.
مصفوفة التقويم (Rubric)
محكّات (مثل الدقة، الوضوح، الملاءمة، التنسيق) للحكم على جودة المخرجات.
نقد/مراجعة (Critique/Review)
تحليل المخرجات لتحديد مكامن القوة والقصور قبل إعادة الصياغة.
مُخرجات منظّمة (Structured Output)
مخرجات بصيغة محددة (مثل JSON) تُسهّل القراءة والمعالجة البرمجية.
دفتر/ملف المُنطلقات (Prompt Book)
تجميعة عملية لنماذج المُنطلقات ودروس التحسين المتعاقبة لتوثيق التجربة.
الهلوسة (Hallucination)
إنتاج النموذج معلومات مُختلَقة أو غير صحيحة بثقة، رغم عدم صحتها.
RLHF
التعلم المعزز من ردود الفعل البشرية؛ تقنية تدريب تُحسّن استجابات النموذج بناءً على تقييم بشري.

10 مصطلحات أساسية لهذه الوحدة.

اختبار الوحدة

يتكوّن الاختبار من 5 أسئلة صح/خطأ، و5 أسئلة اختيار من متعدد، و3 أسئلة إنشائية. تُصحَّح الأسئلة الموضوعية تلقائياً، بينما تعرض الأسئلة الإنشائية إجابة نموذجية لتقييم إجابتك بنفسك.

أولاً: صح أم خطأ

1. يتميز ChatGPT بقدرته على تذكر سياق المحادثة السابقة بفضل تقنية RLHF.

2. نتائج ترميم الصور بالذكاء الاصطناعي هي استعادة مطابقة تماماً للصورة الأصلية بدقة أرشيفية.

3. تعتمد منصة Qwen على كونها مفتوحة المصدر كإحدى أبرز خصائصها.

4. استخدام تنسيق مخرجات مثل JSON يزيد من احتمالية هلوسة النموذج.

5. التعليمات الإيجابية (ماذا يجب أن يفعل النموذج) غالباً أكثر فعالية من القيود السلبية فقط.

ثانياً: اختيار من متعدد

6. أداة Google NotebookLM تعتمد بشكل أساسي على:

7. تقديم مثال أو مثالين للنموذج لتوضيح النمط المطلوب في المخرجات يُسمى:

8. أي عناصر بنية المُنطلق التالية يحدد "الفئة المستهدفة" التي ستقرأ الناتج؟

9. الخطوة التي تلي "التجريب (Run)" مباشرة في دورة Draft-Run-Evaluate-Refine هي:

10. منصة Manus AI توصف بأنها:

ثالثاً: أسئلة إنشائية

11. عدّد العناصر الستة لبنية المُنطلق الواضح، واشرح أهمية عنصرين منها.

العناصر الستة: السياق، الدور، المهمة، القيود، الجمهور، وتنسيق المخرجات. مثلاً، الدور مهم لأنه يوجّه نبرة وأسلوب الاستجابة (كأن يتصرف النموذج كخبير تسويق أو معلم روضة)، بينما تنسيق المخرجات مهم لأنه يجبر النموذج على بنية محددة (كجدول أو JSON) ما يقلل من الهلوسات ويسهّل إعادة استخدام البيانات.

12. قارن بين نمط Few-shot Prompt ونمط Critique/Review Prompt من حيث الفكرة والاستخدام.

Few-shot يعتمد على تقديم مثال أو أكثر مسبقاً للنموذج قبل تنفيذ المهمة، لتوضيح النمط أو التنسيق المطلوب من البداية. أما Critique/Review فهو تفاعل لاحق بعد الحصول على مخرج أولي، حيث يقيّم المستخدم الناتج ويطلب تحسينات محددة (مثل "اجعله أكثر إقناعاً")، أي أنه أسلوب تصحيح تكراري بعد التنفيذ وليس توجيهاً مسبقاً له.

13. اذكر خطوات دورة "التكرار والتنقيح والاختبار"، مع توضيح معايير قياس جودة المخرجات الأربعة.

الخطوات: الصياغة (كتابة مُنطلق أولي)، التجريب (تشغيله على المنصة)، التقييم (فحص جودة الإجابة)، والتنقيح (تعديل المُنطلق بناءً على الملاحظات). معايير الجودة الأربعة: الدقة (صحة المعلومات وخلوها من الهلوسة)، التغطية (شمول كل الجوانب المطلوبة)، القابلية للتنفيذ (مدى فائدة المخرجات عملياً)، والاتساق مع التنسيق (الالتزام بالشكل المطلوب كالجداول أو النقاط).